Domain udmn.de kaufen?
Wir ziehen mit dem Projekt
udmn.de um.
Sind Sie am Kauf der Domain
udmn.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain udmn.de kaufen?
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
Was ist AO Klassifikation?
Die AO-Klassifikation ist ein System zur Klassifizierung von Frakturen, das von der Arbeitsgemeinschaft für Osteosynthesefragen (AO) entwickelt wurde. Sie dient dazu, Frakturen nach ihrem Schweregrad, ihrer Lokalisation und anderen relevanten Faktoren zu klassifizieren. Die AO-Klassifikation hilft Ärzten bei der Entscheidung über die geeignete Behandlung für eine bestimmte Fraktur und ermöglicht eine einheitliche Kommunikation über Frakturen in der medizinischen Fachwelt. Sie ist international anerkannt und wird häufig in der Orthopädie und Unfallchirurgie angewendet. Die AO-Klassifikation besteht aus verschiedenen Kategorien, die jeweils spezifische Informationen über die Fraktur liefern, um eine präzise Diagnose und Behandlung zu ermöglichen. **
Ähnliche Suchbegriffe für Klassifikation
Top-Angebote
Produkte zum Begriff Klassifikation:
-
Was ist die TNM Klassifikation?
Die TNM-Klassifikation ist ein System, das verwendet wird, um den Ausdehnungsgrad von Tumoren zu beschreiben. Dabei werden drei Hauptkriterien berücksichtigt: Tumorgröße (T), Lymphknotenbefall (N) und Metastasen (M). Anhand dieser Kriterien wird der Tumor in verschiedene Stadien eingeteilt, um eine Prognose abzugeben und die geeignete Behandlung zu bestimmen. Die TNM-Klassifikation wird vor allem in der Onkologie verwendet, um die Schwere und das Fortschreiten von Krebserkrankungen zu bestimmen. Sie dient auch dazu, den Verlauf der Erkrankung zu überwachen und die Wirksamkeit der Behandlung zu beurteilen. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **
-
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
-
"Was sind die grundlegenden Prinzipien der Klassifikation von Objekten oder Informationen?" "Warum ist die Klassifikation von Daten und Informationen in verschiedenen Bereichen und Disziplinen wichtig?"
Die grundlegenden Prinzipien der Klassifikation sind die Identifikation von Gemeinsamkeiten, die Gruppierung von ähnlichen Objekten und die Zuordnung zu Kategorien. Die Klassifikation von Daten und Informationen ist wichtig, um Ordnung zu schaffen, den Zugriff zu erleichtern und die Effizienz bei der Verwaltung zu erhöhen. In verschiedenen Bereichen und Disziplinen ermöglicht die Klassifikation eine bessere Organisation, Analyse und Nutzung von Informationen für spezifische Zwecke. **

Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
Top-Angebote
Produkte zum Begriff Klassifikation:
-
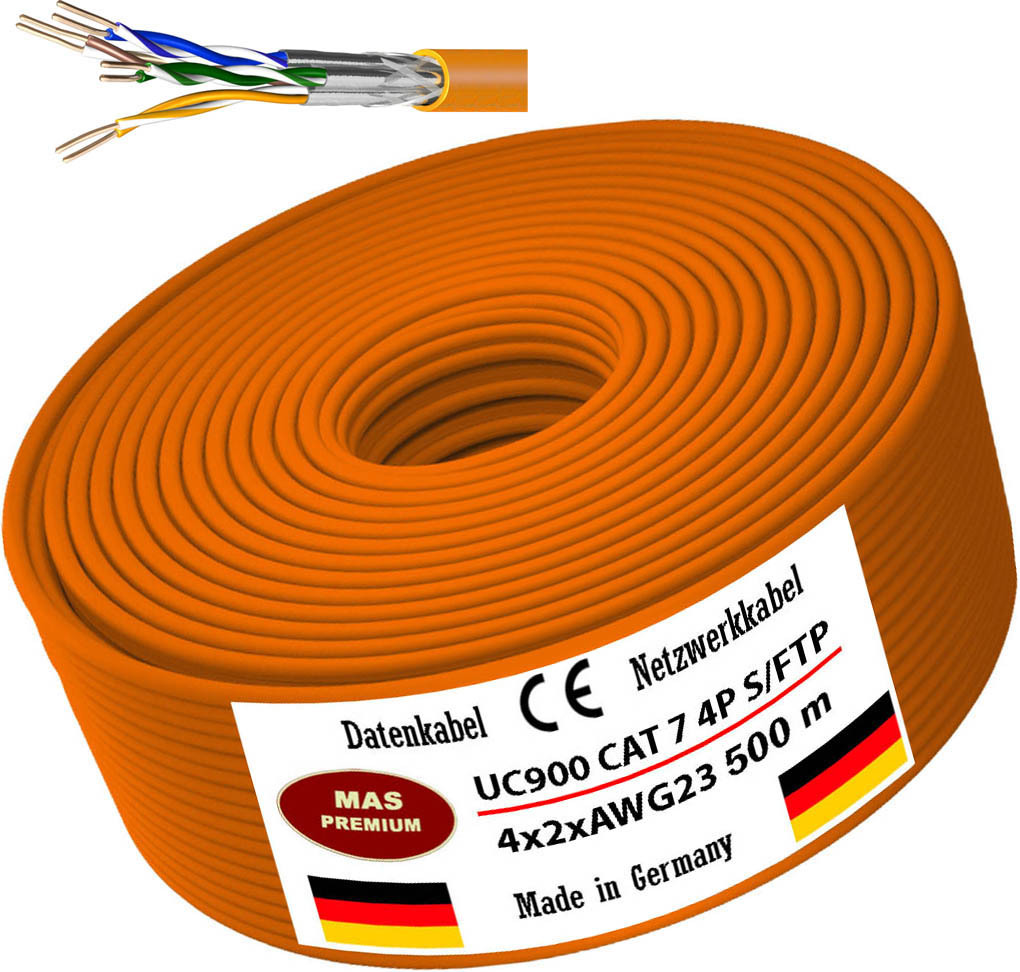
500 m UC900 HS23 CAT 7 Daten- Netzwerk- Verlege- Kommunikationskabel Halogenfrei20% mehr Reichweite bei 10GBit; bis 20% EinsparpotentialVerwendung: Installationskabel für den Innenbereich UC900 HS23 C7 S/FTP 4P LSHF. Kupfer-Datenkabel der Kategorie Kat.7 für die strukturierte Verkabelung mit einer Bandbreite von 1000 MHz. Mit Folienpaarschirmung und und hochwertiger Geflechtsabdeckung ist das Kabel doppelt geschirmt. Das 4-paarige Simplex Verlegekabel mit 8 Kupferadern AWG23ist für den Anschluss von Dosen, Patchfeldern und Modulen, auch mit LSA-Technik, zur Verlegung in Gebäuden, im Kanal und Unterputz geeignet und übertrifft die Anforderungen nach EN 50173-1; EN 50288-4-1, ISO/IEC 11801; IEC 61156-5 und IEEE 802.3 af/at/bt. Der Mantel ist aus halogenfreiem, flammwidrigem MaterialTechnische Daten- Kurzbeschreibung: Datenkabel Netzwerkkabel Installationskabel - Type: UC900 HS23 CAT 7 4P LSHF Eca S/FTP 4X2XAWG23 - Leiter-Nennquerschnitt: 0,64 mm² - Leiter-Durchmesser: Ø 0,56 mm (AWG 23) - Laufender Meter: 500 m - Leiter: Kl.1 = eindrähtig Cu-Draht, blank - Ader-Zahl817,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
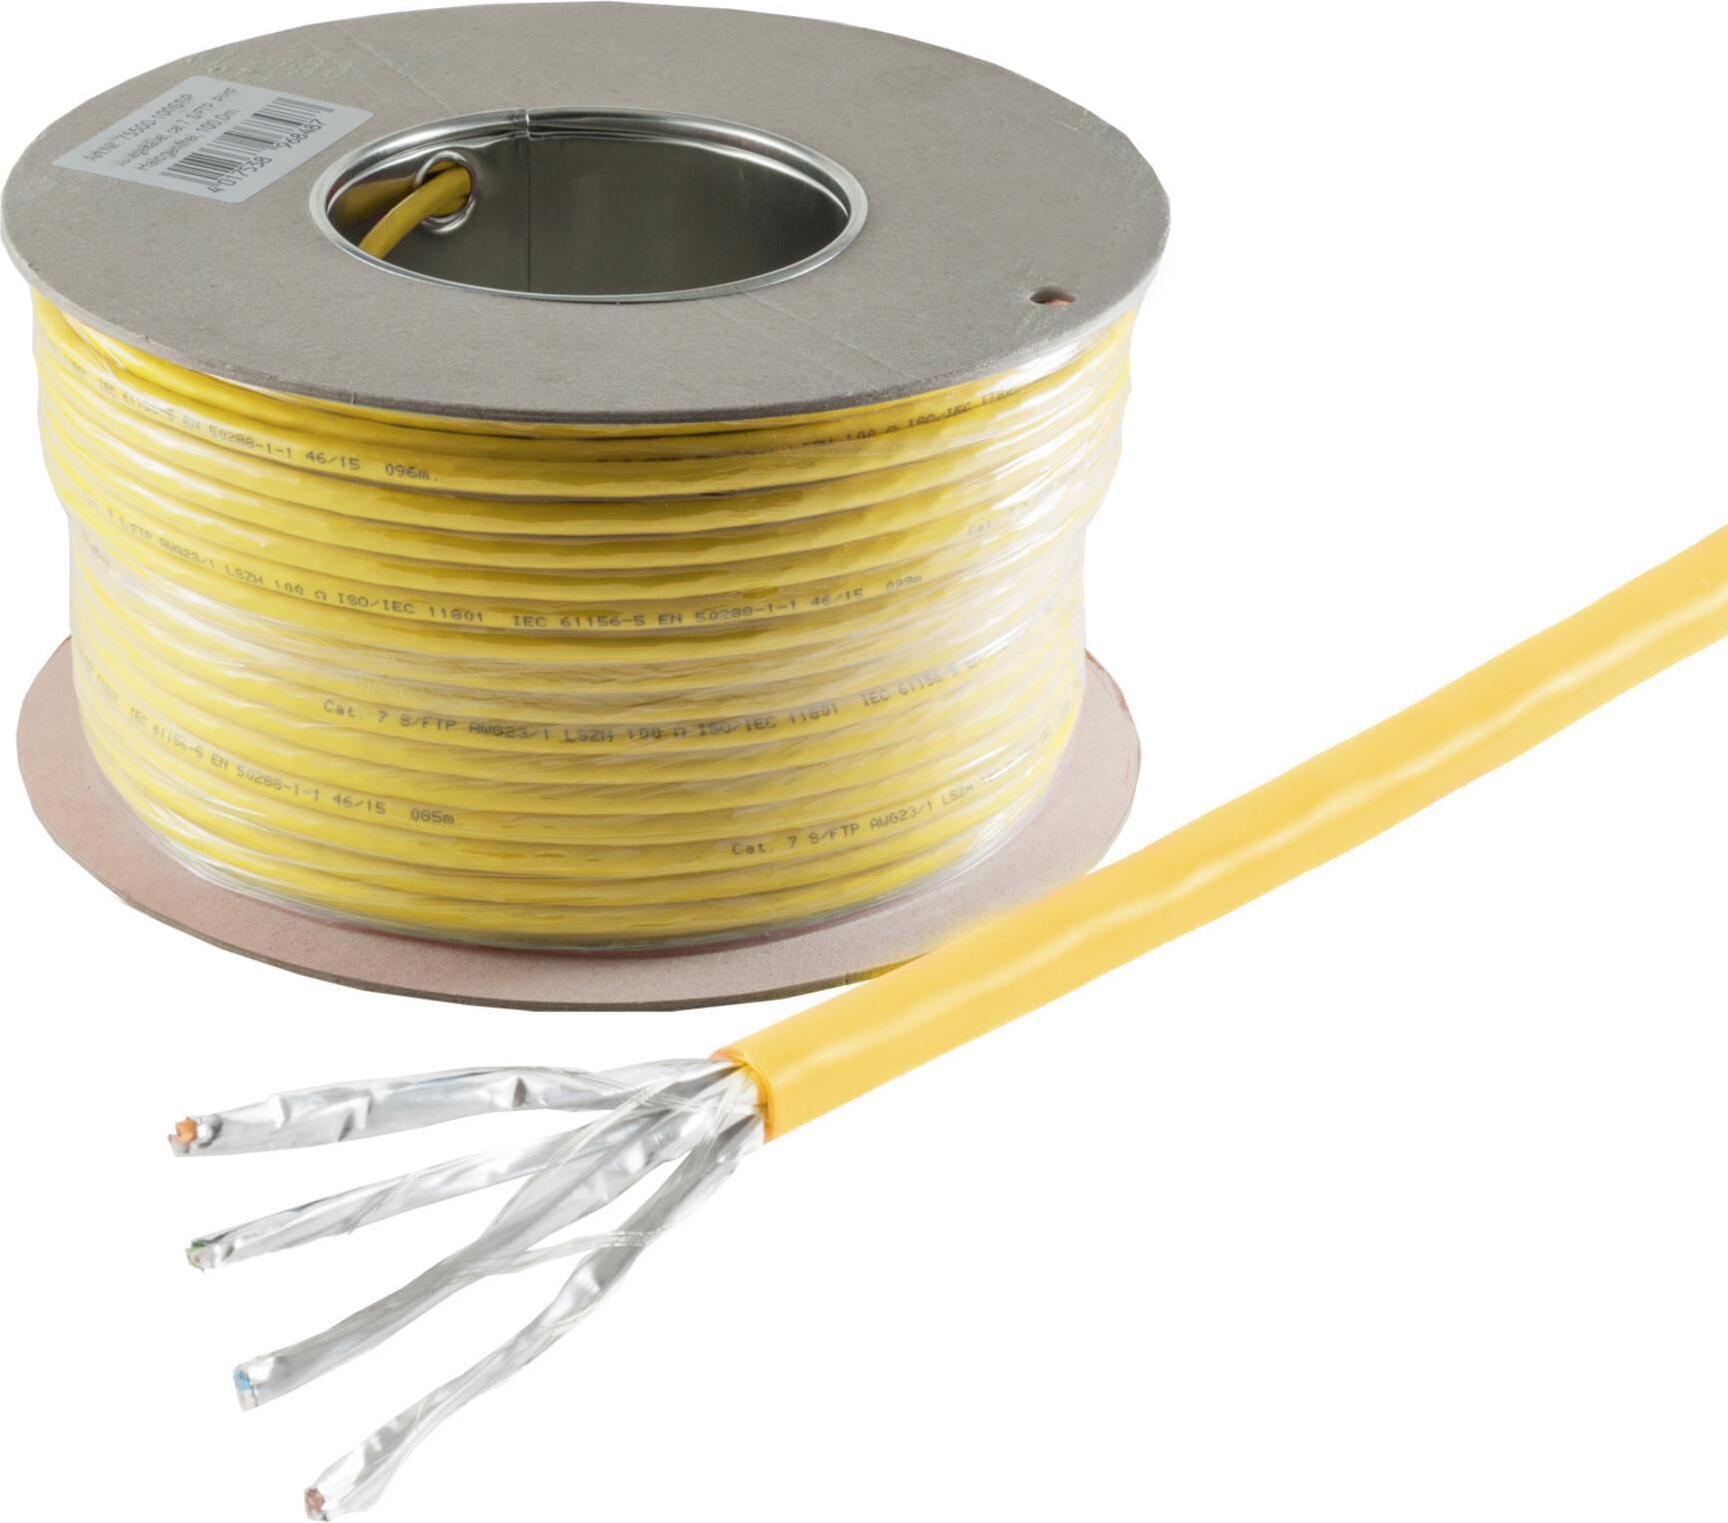
S/CONN, maximale Konnektivität, Cat. 7A+ Installationskabel, S/FTP, halogenfrei (LSZH), gelb - Kabel - NetzwerkCat 7A+ Hochleistungs-Netzwerk-VerlegekabelDieses Cat 7A+ Verlegekabel wurde speziell für anspruchsvolle Netzwerkinfrastrukturen konzipiert. Es unterstützt Bandbreiten bis zu 1200 MHz und eignet sich hervorragend für die Realisierung von strukturierten Verkabelungen in Unternehmen und Datenzentren. Die halogenfreie Ausführung trägt zudem zum Brandschutz bei.Hauptmerkmale:Kategorie: Cat 7A+, S/FTPBandbreite: 1200 MHzSchirmung: PIMF (Paare in Metallfolie)Halogenfrei: Unterstützt erhöhten BrandschutzLänge: 500 MeterTechnische Details:Schirmungsaufbau: Alu Folie 0,025mm + verzinntes KupfergeflechtLeitermaterial: Reines Kupfer (AWG 22/1)Kabeldurchmesser: Spezifikation nicht angegeben, üblicherweise im Bereich Cat 7-SpezifikationKabelfarbe: GelbAnwendungsgebiete: Geeignet für den Einsatz in Industrieumgebungen und Bürogebäuden Cat. 7A+ Netzwerkkabel, geeignet für die strukturierte Gebäudeverkabelung im Innenraum.Auf einen BlickSpezifikationCat. 7A+ (Class FA)Übertragungsfrequenz bis zu1200MH746,44 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
-
Was ist AO Klassifikation?
Die AO-Klassifikation ist ein System zur Klassifizierung von Frakturen, das von der Arbeitsgemeinschaft für Osteosynthesefragen (AO) entwickelt wurde. Sie dient dazu, Frakturen nach ihrem Schweregrad, ihrer Lokalisation und anderen relevanten Faktoren zu klassifizieren. Die AO-Klassifikation hilft Ärzten bei der Entscheidung über die geeignete Behandlung für eine bestimmte Fraktur und ermöglicht eine einheitliche Kommunikation über Frakturen in der medizinischen Fachwelt. Sie ist international anerkannt und wird häufig in der Orthopädie und Unfallchirurgie angewendet. Die AO-Klassifikation besteht aus verschiedenen Kategorien, die jeweils spezifische Informationen über die Fraktur liefern, um eine präzise Diagnose und Behandlung zu ermöglichen. **
-
Was ist die TNM Klassifikation?
Die TNM-Klassifikation ist ein System, das verwendet wird, um den Ausdehnungsgrad von Tumoren zu beschreiben. Dabei werden drei Hauptkriterien berücksichtigt: Tumorgröße (T), Lymphknotenbefall (N) und Metastasen (M). Anhand dieser Kriterien wird der Tumor in verschiedene Stadien eingeteilt, um eine Prognose abzugeben und die geeignete Behandlung zu bestimmen. Die TNM-Klassifikation wird vor allem in der Onkologie verwendet, um die Schwere und das Fortschreiten von Krebserkrankungen zu bestimmen. Sie dient auch dazu, den Verlauf der Erkrankung zu überwachen und die Wirksamkeit der Behandlung zu beurteilen. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **
Ähnliche Suchbegriffe für Klassifikation
-
HP Enterprise HP USB 3.0 to Gig RJ45 Adapter G2 Digital/Daten Netzwerk (4Z7Z7AA)Produktbeschreibung: HP USB 3.0 to RJ45 Adapter G2 - Netzwerkadapter - USB 3.0 - Gigabit Ethernet x 1, Gerätetyp: Netzwerkadapter, Formfaktor: Extern, Schnittstellentyp (Bustyp): SuperSpeed USB 3.0, Ports: Gigabit Ethernet x 1, Abmessungen (Breite x Tiefe x Höhe): 17,2 cm x 2,1 cm x 1,5 cm, Gewicht: 21 g, Verdrahtungstyp: Ethernet 10Base-T, Ethernet 100Base-TX, Ethernet 1000Base-T, Data Link Protocol: 10Mb LAN, 100Mb LAN, 1GbE, Datenübertragungsrate: 1 Gbps, Produktzertifizierungen: USB 3.0, Systemanforderungen: Windows 10, Windows 11, Entwickelt für: HP 245 G10 Notebook, 250 G9 Notebook; Fortis 11 G9 Q Chromebook22,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
-
"Was sind die grundlegenden Prinzipien der Klassifikation von Objekten oder Informationen?" "Warum ist die Klassifikation von Daten und Informationen in verschiedenen Bereichen und Disziplinen wichtig?"
Die grundlegenden Prinzipien der Klassifikation sind die Identifikation von Gemeinsamkeiten, die Gruppierung von ähnlichen Objekten und die Zuordnung zu Kategorien. Die Klassifikation von Daten und Informationen ist wichtig, um Ordnung zu schaffen, den Zugriff zu erleichtern und die Effizienz bei der Verwaltung zu erhöhen. In verschiedenen Bereichen und Disziplinen ermöglicht die Klassifikation eine bessere Organisation, Analyse und Nutzung von Informationen für spezifische Zwecke. **
-
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.